
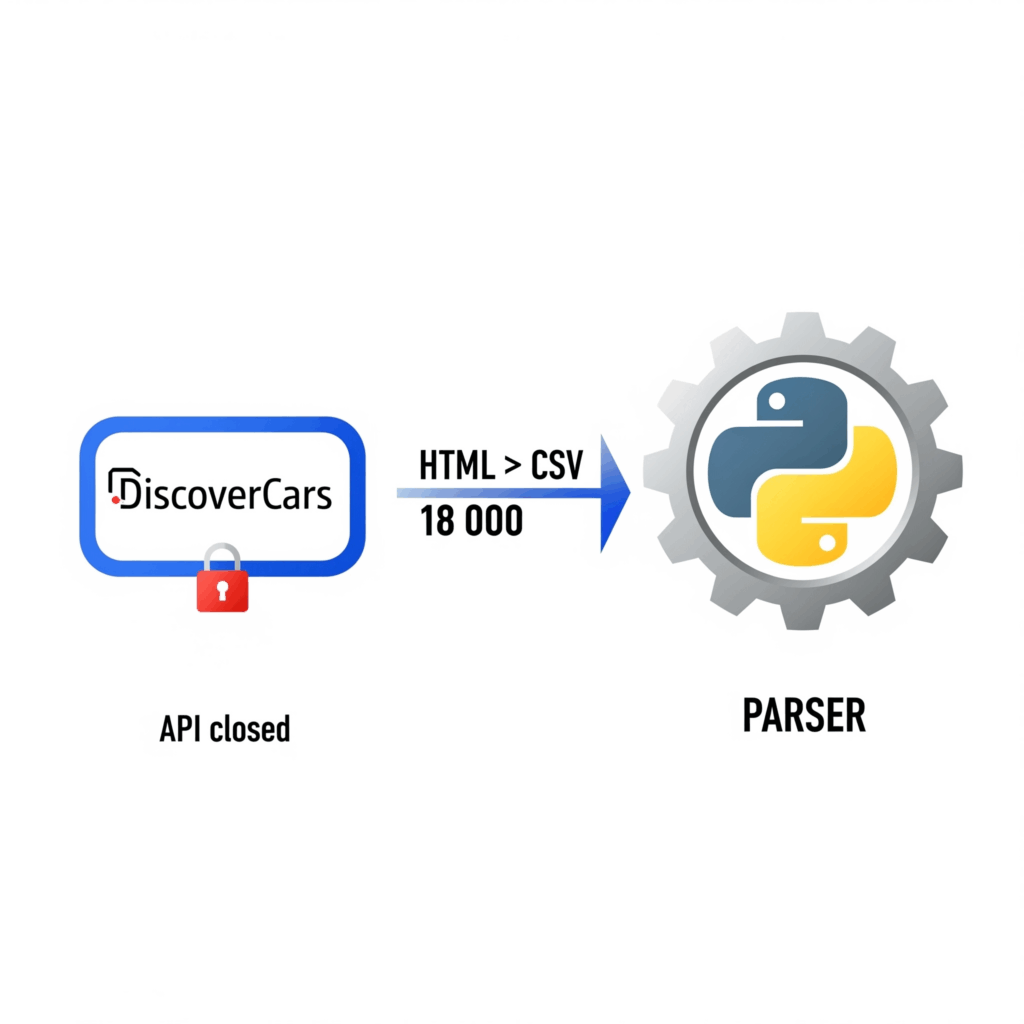
Есть у меня в копилке кейс, в котором мне пришлось спарсить 18000 объектов у партнерки DiscoverCars, которая входит в Travelpayouts и у которого, вроде как, есть официальный API. Однако:
- доступ к API получают только сайты с большим трафиком (≈50 000 пользователей в месяц) и необходимостью туристической тематики (по одному из пунктов вроде как проходим).
- там нет координатной привязки.
В отсутствие такого доступа приходится создавать собственный парсер (собственно чем я и занялся и откуда и родился этот кейс).
Анализ проблемы и выбор оптимальных подходов для реализации парсера на Python под эту задачу
Давайте немного порассуждаем над проблемой более глобально. Мне понадобилось спарсить несколько тысяч локаций, собственно при однопоточном подходе основная «узкая» часть – сетевой ввод-вывод: каждая страница тратит много времени на загрузку. Профилирование подтвердило, что время загрузки критически важно, а простая оптимизация кода без параллелизма практически не ускорит процесс. Для таких IO-заданий переход к параллельным запросам вполне оправдан: «поскольку вы используете requests.get, задача зависит от сети (IO-bound), и применение потоков здесь корректно. Однако, очевидные сложности: при слишком частых запросах сайт может начать блокировать IP, а создание сотен потоков приводит к накладным расходам и синхронизации. По опыту, при типичных сетевых сценариях разумное число потоков измеряется десятками; около 10 потоков – хорошая отправная точка.
Я рассмотрел следующие подходы:
- Официальный API Travelpayouts. Он сразу даёт списки локаций и автомобилей (методы locations, getCars и пр.), что избавляет от работы «вслепую». Однако проактивное получение доступа к API обычно невозможно если у вас небольшой по трафику сайт (да я и просто пропустил этот вариант, так как привык решать проблему по другому).
- Многопоточность. Классическая модель с пулом потоков (модуль threading или concurrent.futures.ThreadPoolExecutor). Потоки разделяют данные и легко обрабатывают ожидание сетевых ответов; GIL при этом не мешает сетевым операциям. Единственный поток выполняет парсинг HTML после получения данных, но большинство времени всё равно уходит на ожидание сети, что оправдывает поточный подход.
- Многопроцессность. При очень большом объёме данных можно вообще разделить задачу на несколько процессов. Один вариант – разбить список ссылок на N частей и запустить N копий скрипта (с параметром смещения). Например:
$ python3 parser.py links.txt 0
$ python3 parser.py links.txt 1
…
$ python3 parser.py links.txt 15
При этом каждый процесс берёт строки по модулю (используя параметр). Такой подход прост и позволяет масштабировать сбор данных вне кода.
- Защита от блокировок. Чтобы избежать блокировки, будет полезно использовать пул прокси и ставить паузы между запросами. Если сайт позволяет работать с IPv6, можно приобрести несколько прокси-адресов и равномерно менять их. Собственно это я и делал в своем скрипте. По хорошему, для задач по парсингу лучше использовать резидентные прокси, по своему опыту я рекомендую именно их. Датацентр много хуже — они очень просто детектятся сайтами, которые вы парсите, а мобильные при прочих равных стоят дороже (но по надежности, конечно же не уступают резидентным и даже превосходят их), поэтому экономически не оправдано их использовать на простом парсинге.
Таким образом, мы комбинируем возможности потоков для ускорения, уделяя внимание лимитам сайта. В частности, будьте готовы к блокировке при частых запросах, поэтому внедряем таймауты и резервные схемы запросов (например, поэтапное разделение задач по модулям). Общий выбор: многопоточный парсер с контролем частоты запросов, дополненный логированием и, при необходимости, разделением на процессы.
Архитектура парсера
Теперь немного о самом парсере на Python:
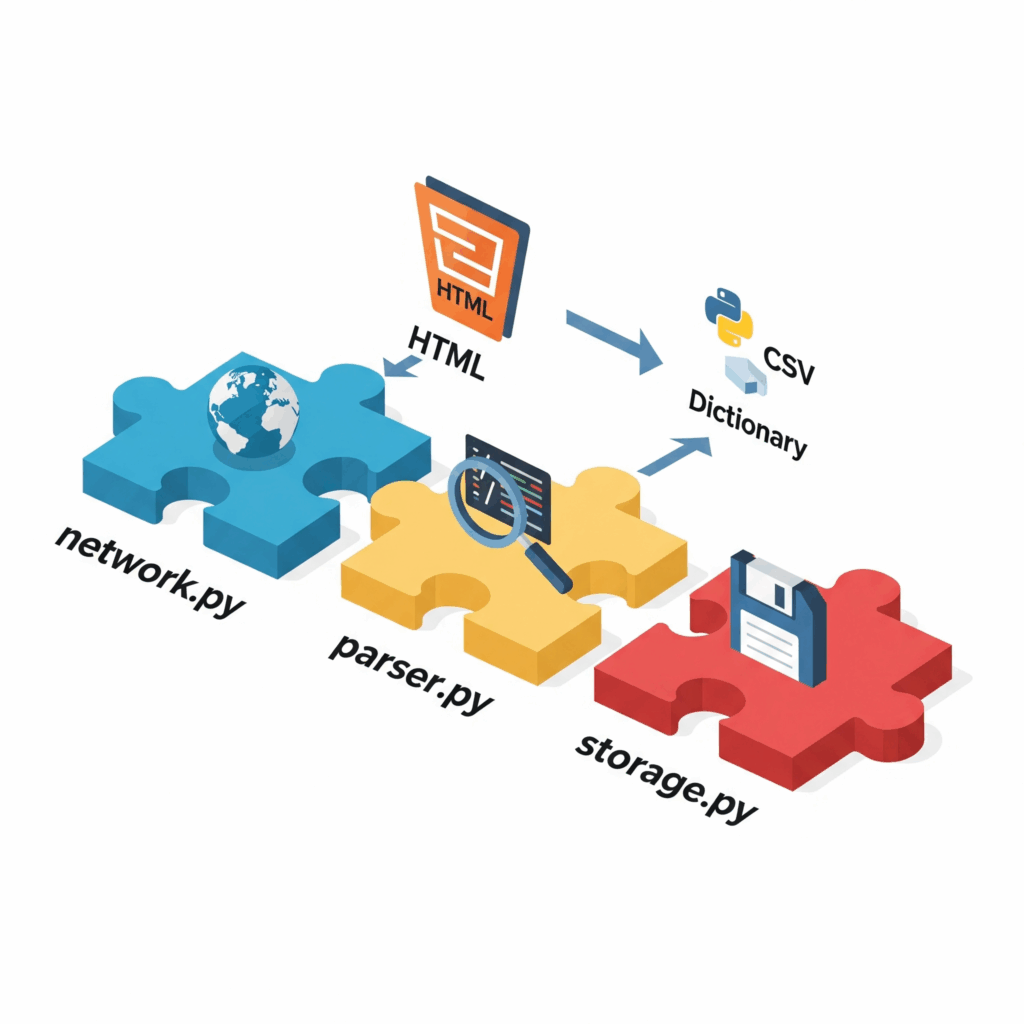
Парсер организован в виде набора функций: получение HTML, разбор ссылок и сохранение результатов. В самом простом случае алгоритм такой: сперва с помощью функции get_html(url) по requests загружаем страницу и проверяем код ответа. Затем get_all_links(html) извлекает из главной страницы список ссылок на города или страны (например, из раздела «Car rental locations»). Для каждой такой ссылки запускается функция parse_location(html), которая с помощью BeautifulSoup или lxml находит на странице названия филиалов, геопозиции или другие нужные поля. Наконец, собранные данные сохраняются в CSV (файл results.csv), с учётом первичной очистки (удаление дублей, кодировка UTF-8).
Важный момент – повторное использование уже полученных данных. Если парсер падает или разворачивается заново, он читает уже сохранённые города и продолжает со следующего. Также реализована обработка ошибок запросов: если при get_html ответ ≠200, отправляем повторный запрос или помечаем ссылку как ошибочную. Для каждого основного этапа (получение списка, парсинг конкретной страницы) написаны отдельные функции — это позволяет легче отслеживать сбои и расширять функциональность (например, добавить получение координат через геокодер, если понадобится).
Парсер поддерживает чёткое разделение обязанностей: один модуль отвечает за сетевое взаимодействие (requests), другой – за парсинг HTML (BeautifulSoup), третий – за сохранение и мониторинг. Имена функций и переменных организованы по принципу «одна ответственность»: генерация URL, чтение/запись файлов и парсинг не смешиваются. Это упрощает тестирование и сопровождение. Если нужно изменить формат выходных данных (CSV → JSON), достаточно поменять функции сохранения, не затрагивая логику парсинга.
Реализация многопоточности
Параллельность достигается через пул рабочих потоков (ThreadPoolExecutor или multiprocessing.dummy.Pool). Основная логика такова: собираем все URL для обработки (сперва – все страны/регионы, потом из них – конкретные города), формируем список задач. Затем вызываем пул, например: executor.map(parse_location, list_of_links). Каждая задача – это функция, которая делает requests.get, ждёт ответа и парсит HTML.
За счёт многопоточности несколько запросов выполняются одновременно. При этом важно выбрать число потоков осознанно: слишком много потоков лишь создает накладные расходы на переключение и синхронизацию. На практике для сетевых запросов порядка 10–20 потоков часто достаточно. Количество потоков можно регулировать динамически или задавать в конфигурации. Во время выполнения парсер подсчитывает успешные и неуспешные запросы: при серии ошибок (например, сайт перестал отвечать) он приостанавливает работу, даёт время остаться в рамках ограничений.
Если один поток уже загрузил страницу, другой может одновременно загружать следующую, тем самым скрывая задержки сети. Каждый поток будет тратить часть времени на ожидание сетевых данных, а в это время другие потоки могут выполнять полезную работу. Поскольку GIL не блокирует операции ввода-вывода, потоки эффективно перемежают запросы.
При необходимости учтены и ограничения Python: тяжелый разбор HTML библиотекой BeautifulSoup выполняется в основном в одном потоке (GIL удерживается при парсинге строки), поэтому при очень большом числе потоков парсинг может стать «бутылочным горлышком». Если парсинг HTML занимает значительное время, можно было бы перейти на multiprocessing.Pool, но на начальном этапе мы нашли, что сетевые задержки доминируют, и ограничились потоками.
Производительность и оптимизация
Оценка производительности проводилась сравнением времени выполнения различных конфигураций. Многопоточный вариант показал значительно лучшие результаты по сравнению с последовательным. При тестах на конечных данных накладные расходы потоков окупились уже при 5–10 потоках: общее время упало примерно в 5–7 раз по сравнению с одним потоком (точный коэффициент зависит от пропускной способности сети и времени ответа сервера).
Экспериментальный подбор числа потоков был особенно полезен, я проверил несколько значений и остановились на 8 потоках, тут выигрыш по времени перестал расти.
Для точного профилирования частей кода использовали замеры времени функций. Например, с помощью time.monotonic() можно измерять длительность каждой загрузки и парсинга. Путём анализа такого профиля стало ясно, что время на requests.get доминирует, а собственно разбор HTML занимает существенно меньше времени. Это подтвердило выбор именно IO-подхода к параллельности.
В итоге оптимизации: много потоков ускорили получение данных, а для обработки результатов (запись в файл, формирование CSV) использовалась стандартная буферизация и сброс по завершении каждого парсинга, чтобы не тратить лишнего времени на дисковые операции. Для особо крупных запусков можно использовать сжатие и сериализацию данных (например, сохранять результаты сразу в бинарном формате или базу данных), но в моей задаче CSV оказался приемлемым.
Телеметрия и логирование
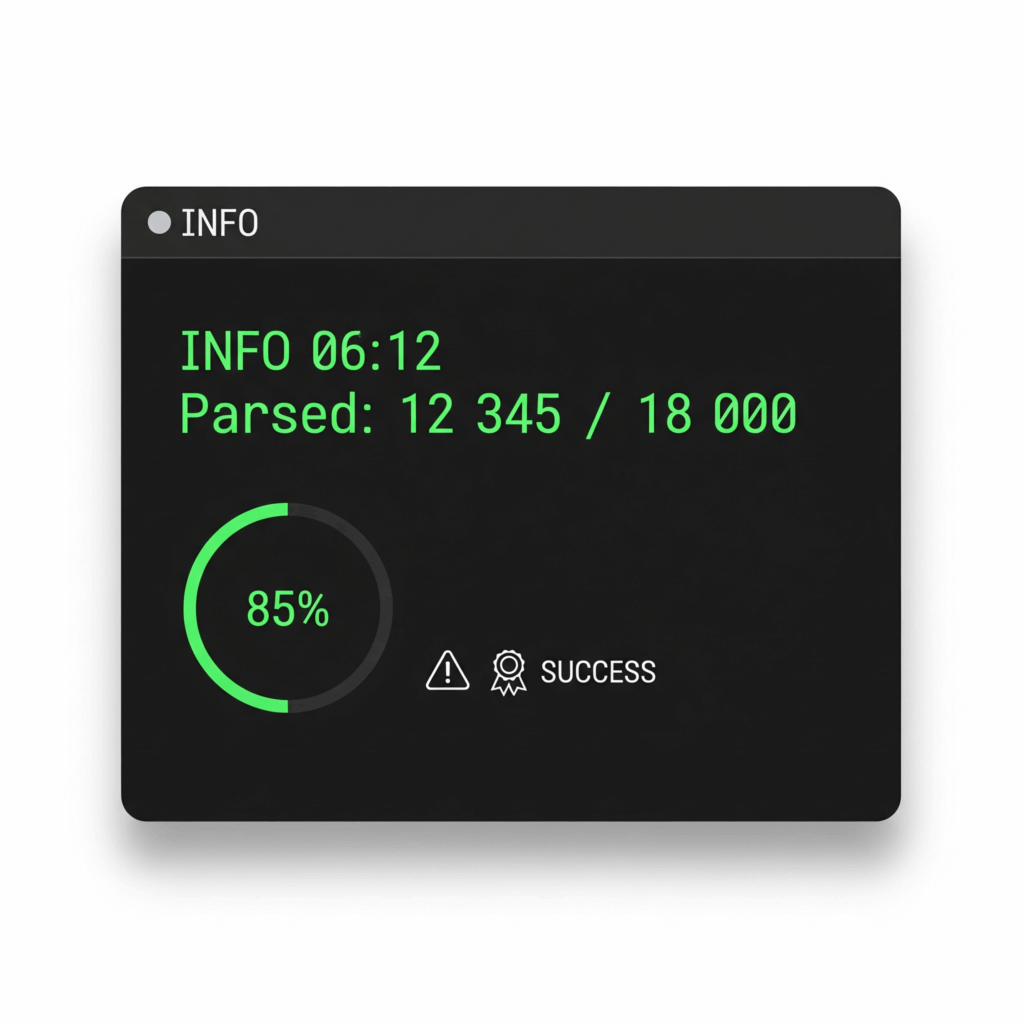
Парсер ведёт простую телеметрию для мониторинга хода работы. Использован Python-логгер (logging) с указанием уровня INFO: каждый успешный запрос и найденный объект (например, город или точка выдачи) фиксируется в выходном файле и кратко логируется на экран. При ошибках (Response != 200 или исключениях requests) события записываются как WARNING. Также подсчитываются метрики: количество обработанных ссылок, число совпадений, число неудачных попыток.
Чтобы анализировать производительность, я сохранял время начала и конца работы парсера, а также время каждого этапа по нескольким записям. Метод time.monotonic() позволяет точно отмерять, сколько ушло на загрузку и парсинг. Собирая такие данные (можно хранить их в логах или метриках), удобно отслеживать узкие места и проверять, не изменились ли лимиты сервера.
При необходимости можно интегрировать более продвинутые системы мониторинга (Prometheus, Sentry и пр.), но в базовом варианте парсер выводит в консоль простую статистику по завершении: общее время, число проверенных локаций и т.д. Такой подход «инструментации» особенно полезен при длительных запусках, позволяя увидеть прогресс и возможные аномалии (например, резкие падения скорости или массовые ошибки, указывающие на блокировку).
Заключение
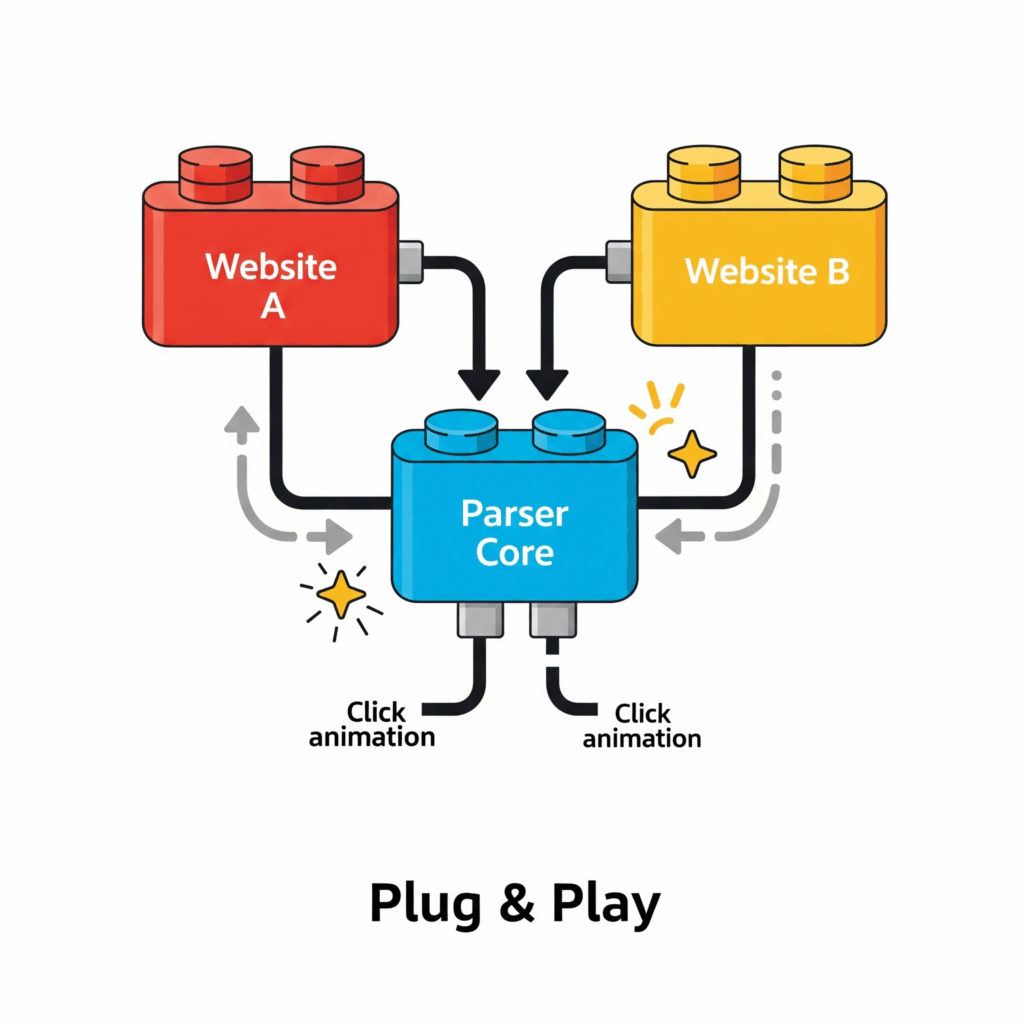
Итоговая система – многопоточный Python-скрипт – позволяет эффективно собрать нужные геоданные с сайта DiscoverCars, обходя ограничения сервиса. При параллельной загрузке скорость сбора возрастает на порядок, а с помощью логирования и профилирования поддерживается контроль качества работы. Если понадобится дальнейшее расширение (дополнительные поля, новые форматы данных, другая геокарта), то модульная архитектура и подробная телеметрия помогут быстро адаптировать код.
Описанные методы универсальны: они применимы не только к DiscoverCars, но и к парсингу других географически-ориентированных сайтов проката автомобилей или турагентств. Можно переписать скрипт под себя и использовать в своих задачах.
Парсер на Python доступен в моем репозитории на Гитхаб, можно тестить и править под себя! Ну и подробный разбор у меня в аккаунте на Хабре — парсер на Python.